TL;DR
- 부트스트랩(bootstrap) 은 표본 하나만으로 평균 같은 통계량이 표본마다 얼마나 흔들리는지 재는 재표집(resampling) 방법이다.
- 가진 표본을 모집단 대신으로 보고 값을 되돌려 놓으며 다시 뽑는 복원추출로 가짜 표본을 수천 개 만든다.
- 가짜 표본마다 통계량을 계산하면 그 값들의 분포가 표집분포(표본을 새로 뽑을 때마다 통계량이 흩어지는 모양)를 근사한다.
- 표집분포가 퍼진 정도가 표준오차이고 가운데 95% 범위가 신뢰구간이다.
- 정규분포 같은 모양을 미리 가정하지 않는 비모수 방법이라 공식이 없는 통계량에도 쓸 수 있다.
부트스트랩
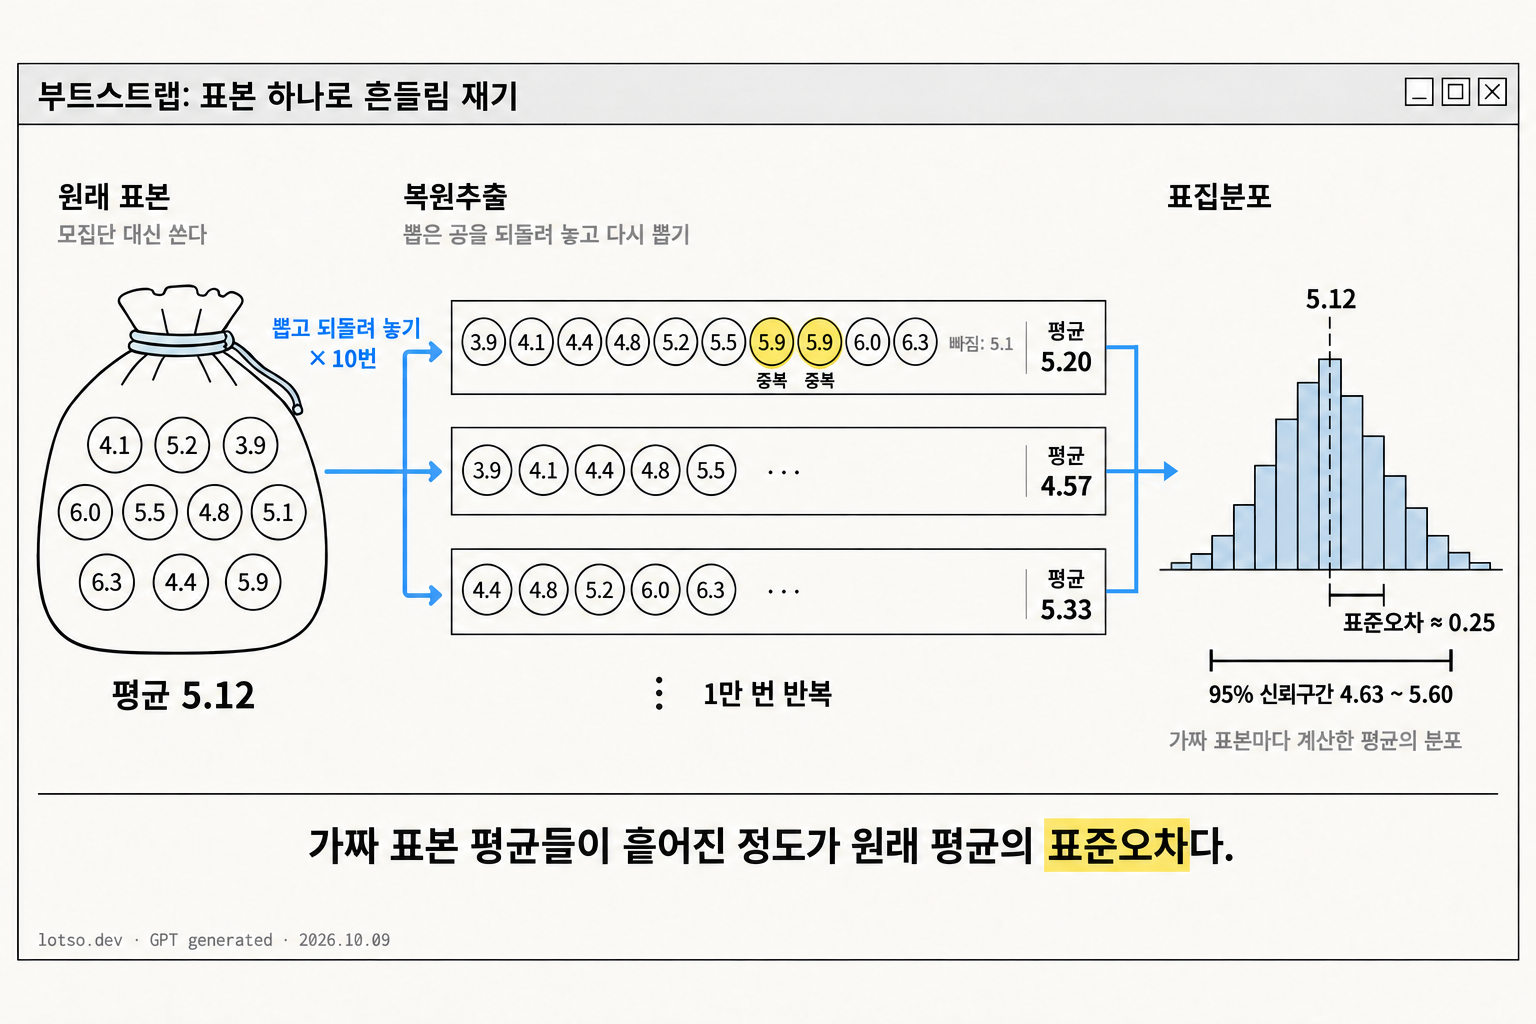
표본 평균처럼 표본으로 모집단의 값을 추정하는 계산 규칙을 추정량(estimator)이라고 한다. 추정량의 불확실성을 알려면 원래는 모집단에서 표본을 여러 번 새로 뽑아 통계량이 얼마나 변하는지 봐야 한다. 하지만 현실에서는 표본이 하나뿐이다. 부트스트랩은 이 표본 하나를 모집단의 근사로 보고 같은 크기 으로 복원추출을 반복해 가짜 표본(bootstrap sample)을 많이 만든다. 각 가짜 표본에서 통계량을 계산하면 그 값들의 분포가 추정량의 표집분포를 근사한다.
복원추출이므로 한 가짜 표본 안에서 같은 관측치가 여러 번 뽑히거나 아예 빠질 수 있다. 이 무작위성이 "표본을 다시 뽑았다면 통계량이 어떻게 달라졌을까"를 흉내 낸다.
보통 부트스트랩이라고 하면 관측 표본(경험분포)에서 복원추출하는 비모수 부트스트랩(non-parametric bootstrap)을 가리킨다. 데이터에 특정 분포족을 맞춘 뒤 그 분포에서 표본을 만드는 모수 부트스트랩(parametric bootstrap)도 있다.
직관
표본 10개의 평균이 라고 하자. 이 평균은 표본을 새로 뽑을 때마다 조금씩 달라질 텐데 표본이 하나뿐이라 그 변동 폭을 직접 볼 수 없다.
부트스트랩은 이 10개에서 복원추출로 10개를 다시 뽑는 일을 수천 번 반복한다. 어떤 가짜 표본은 큰 값이 여러 번 뽑혀 평균이 높고 어떤 표본은 낮다. ==이렇게 모인 수천 개의 평균이 흩어진 정도가 원래 평균의 표준오차이고 가운데 95%를 잘라낸 범위가 [[신뢰구간]]이다.== 가운데를 잘라 구간을 만드는 이 방식을 백분위(percentile) 방식이라고 한다.
절차
- 크기 의 원본 표본에서 복원추출로 크기 의 가짜 표본을 만든다.
- 가짜 표본에서 관심 통계량(평균, 중앙값, 상관계수 등)을 계산한다.
- 1–2를 번(보통 수천~1만) 반복해 통계량 개를 모은다.
- 이 개의 분포로 추정한다.
- 표준오차: 부트스트랩 통계량들의 표준편차다.
- 신뢰구간: 통계량들의 백분위 구간을 쓰거나 치우침을 보정한 BCa 구간을 쓴다.
산출물
부트스트랩이 내놓는 것은 추정이다. 추정값 하나에 그치지 않고 그 값이 얼마나 불확실한지를 숫자로 나타낸다.
- 표준오차(SE): 추정량이 표본에 따라 얼마나 흔들리는지 나타낸다.
- 신뢰구간(CI): 추정량의 불확실성을 구간으로 나타낸다. 표본을 새로 뽑아 같은 절차를 반복하면 정해진 비율(예: 95%)로 모수(모집단 전체에서 정해진 값)를 포함하도록 만든 구간이다. 백분위 방식은 부트스트랩 분포의 2.5%·97.5% 분위수를 쓰고 분포가 한쪽으로 치우쳤으면 이를 보정하는 BCa(bias-corrected and accelerated)가 더 적절할 수 있다.
- 편향(bias): 부트스트랩 통계량 평균과 원래 추정값의 차이로 근사한다.
중앙값·분위수·상관계수처럼 표준오차를 공식으로 구하기 어려운 통계량의 신뢰구간도 같은 절차로 얻을 수 있다.
순열 검정과의 차이
순열 검정과 부트스트랩은 둘 다 재표집(resampling)이지만 목적과 방식이 다르다.
| 부트스트랩 | 순열 검정 | |
|---|---|---|
| 목적 | 추정 (표준오차·신뢰구간) | 가설검정 (p-value) |
| 재표집 | 복원 추출 | 비복원 재배열 |
| 표본 크기 | 원본과 같은 을 복원추출 | 원본 그대로, 라벨·짝만 섞음 |
| 귀무가설 | 불필요 | 필요 (교환가능성) |
| 산출 | 추정량의 표집분포·SE·CI | 귀무분포·p-value |
한계와 주의점
작은 표본에서 불안정하다
부트스트랩은 표본을 모집단의 대용으로 쓴다. 표본이 작으면 이 대용이 모집단을 제대로 대표하지 못해 표준오차와 신뢰구간이 부정확해진다.
매끄럽지 않은 통계량에서 실패할 수 있다
최댓값·최솟값처럼 경계에 의존하는 통계량은 복원추출에 대해 불연속적으로 움직인다. 이런 통계량에서는 단순 부트스트랩이 일관성을 잃을 수 있다.
백분위 구간은 치우친 분포에 약하다
추정량의 분포가 한쪽으로 치우치면 단순 백분위 구간이 모수를 잘 포함하지 못한다. BCa나 basic 방식이 치우침과 편향을 보정하지만 작은 표본 문제까지 풀지는 못한다. 부트스트랩 분포가 한 값에 몰려 퍼짐이 없어지면(퇴화, degenerate) BCa는 NaN을 내기도 한다. 표본이 작거나 통계량이 불안정할 때는 백분위·BCa·basic 구간을 함께 비교하고 데이터 맥락에 비추어 판단한다.
관측치 독립을 가정한다
시계열·군집처럼 관측치가 서로 종속이면 무작위 복원추출이 그 의존 구조를 깨뜨린다. 연속된 구간을 통째로 뽑는 블록 부트스트랩(block bootstrap)처럼 구조를 보존하는 변형이 필요하다.
차이가 한쪽 방향뿐이면 구간이 0을 포함하지 않기 쉽다
부트스트랩은 원래 표본에 있는 값에서 다시 뽑는다. 원래 자료에 음수 차이가 하나도 없으면 가짜 표본의 평균도 0 아래로 내려가지 않는다.
예를 들어 두 방법의 점수 차이를 문서 30개에서 쟀더니 5개는 +1이고 25개는 0이었다고 하자. 음수는 하나도 없다.
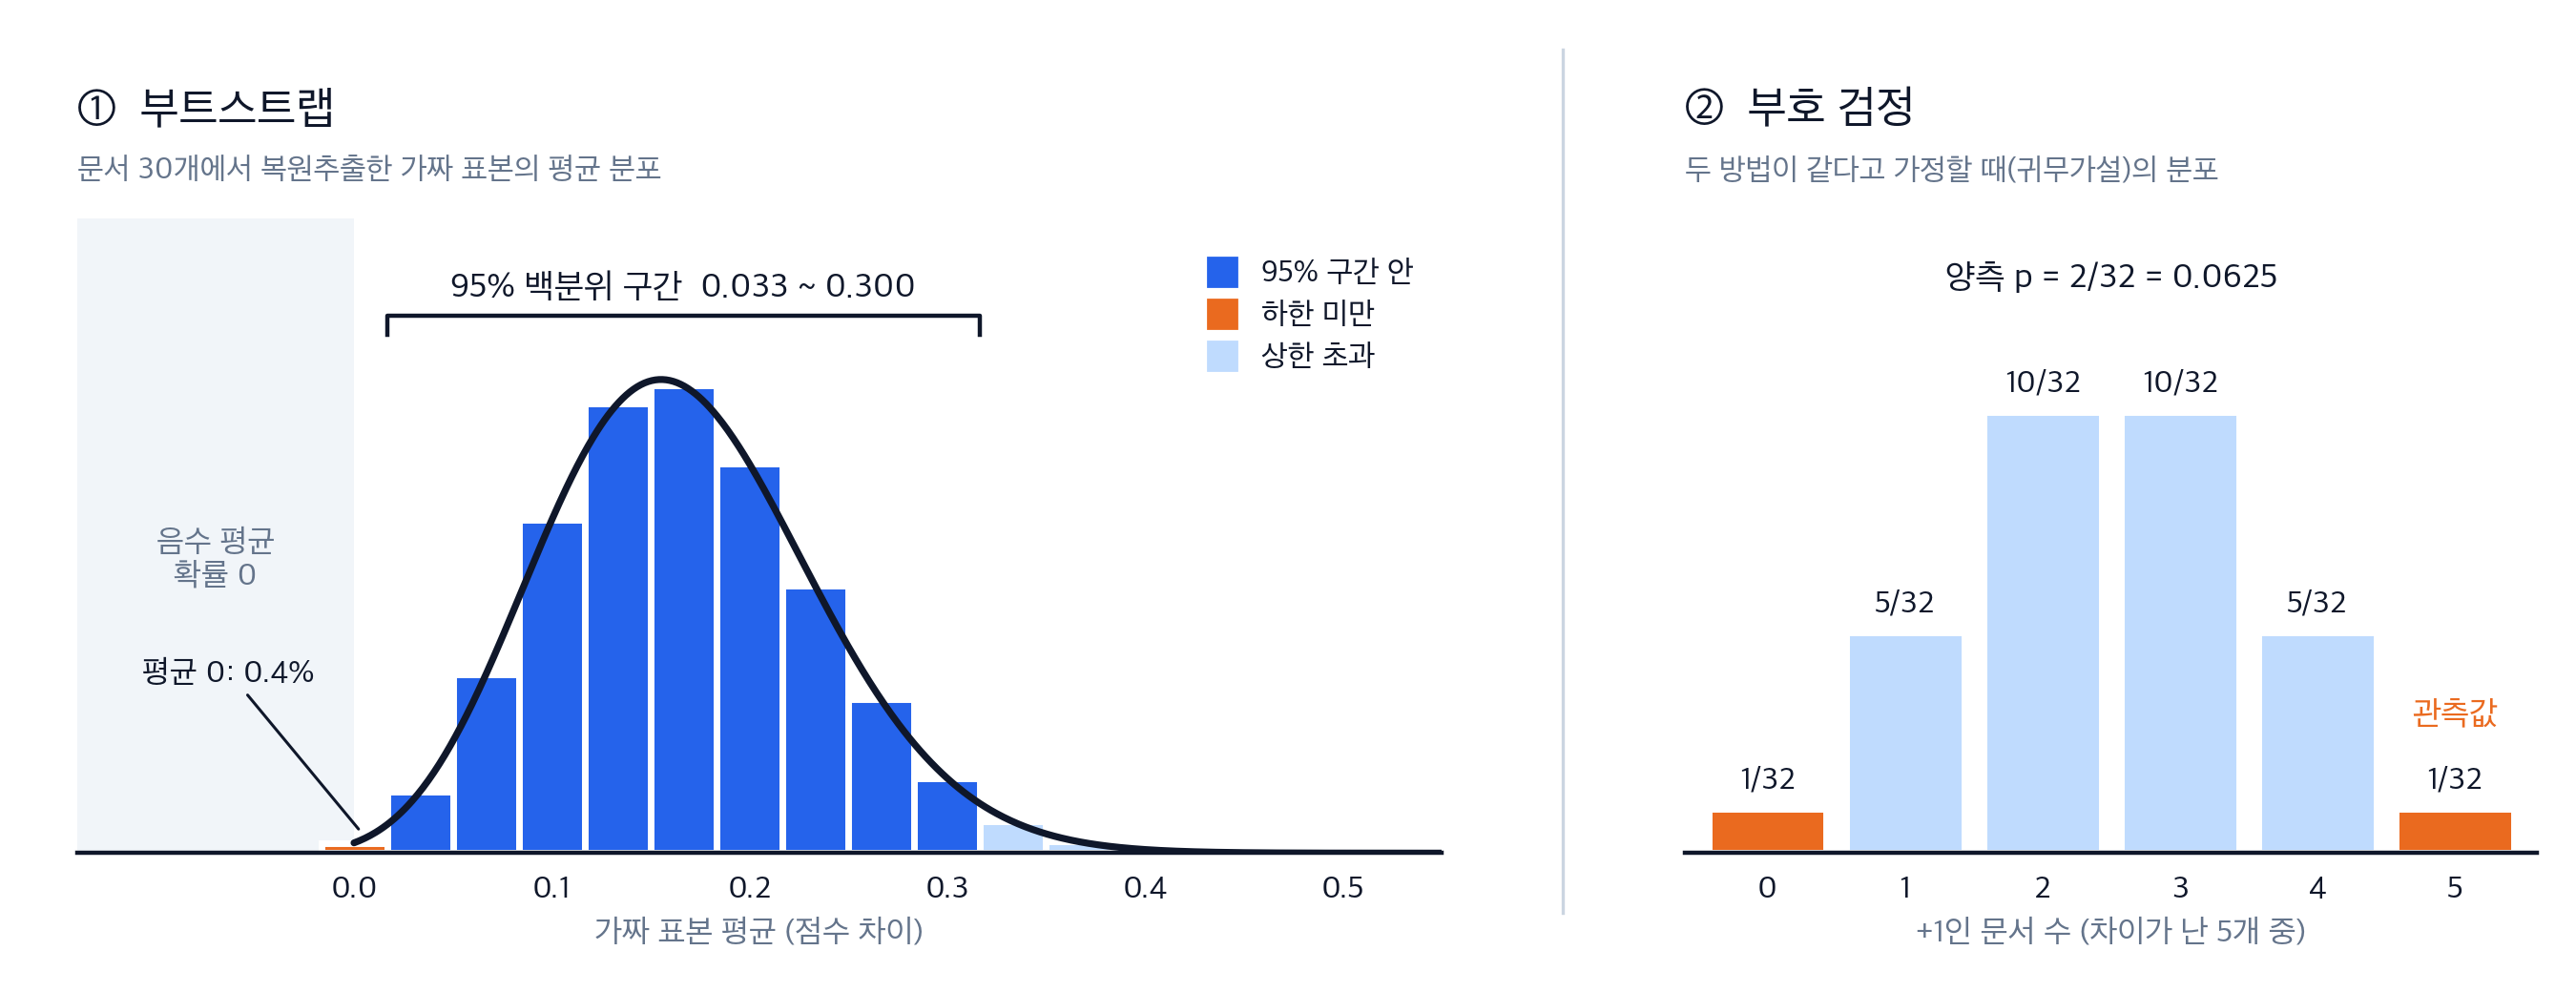
그림 ①은 가짜 표본 평균의 분포다. 평균이 0인 경우는 0.4%뿐이라 아래 2.5% 지점이 0보다 위에 걸린다. 95% 구간은 0.033~0.300이 되어 0을 포함하지 않는다. 차이의 신뢰구간이 0을 포함하지 않으면 보통 차이가 있다고 판단하므로 이 구간만 보면 "차이가 있다"고 읽게 된다.
그림 ②는 같은 자료에 부호 검정(sign test)을 적용한 결과다. 두 방법의 성능이 같다면(귀무가설) 차이가 난 문서 5개는 각각 반반의 확률로 +1 또는 −1이 된다. 동전 5번 던지기와 같은 셈이다. 5개가 모두 같은 쪽으로 나올 확률은 모두 +1인 경우와 모두 −1인 경우를 합쳐 다. 이 값이 기준 5%보다 크므로 이 결과는 우연으로도 충분히 나올 수 있고 차이가 있다고 말할 근거가 부족하다. 두 모델이 같은 문항을 맞혔는지 비교하는 [[맥네마 검정]]도 결과가 엇갈린 문항으로 같은 계산을 한다.
차이 난 사례가 적고 모두 한쪽 방향이면 효과가 있든 없든 부트스트랩 구간이 0을 포함하지 않기 쉽다. 이런 구간은 동전 계산처럼 확률을 직접 구하는 방법으로 다시 확인한다.
구현
import numpy as np
from scipy import stats

data = np.array([4.1, 5.2, 3.9, 6.0, 5.5, 4.8, 5.1, 6.3, 4.4, 5.9])

# 1) 직접 구현
rng = np.random.default_rng(0)
B = 10_000
boot = np.array([rng.choice(data, size=len(data), replace=True).mean()
                 for _ in range(B)])
se = boot.std(ddof=1)                       # 표준오차 ≈ 0.246
ci = np.percentile(boot, [2.5, 97.5])       # 95% percentile CI ≈ [4.63, 5.60]

# 2) SciPy
res = stats.bootstrap(
    (data,), np.mean,
    n_resamples=10_000,
    confidence_level=0.95,
    method="percentile",        # "percentile" | "basic" | "BCa"(기본값)
    rng=0,                       # SciPy ≥1.15 (구버전은 random_state)
)
print(res.standard_error, res.confidence_interval)scipy.stats.bootstrap은 데이터와 통계량 함수를 받아 표준오차와 신뢰구간을 돌려준다. 구간 계산 방식(method)은 percentile·basic·BCa를 지원하고 기본값은 BCa다.1 BCa는 부트스트랩 분포가 한쪽으로 치우친 경우를 보정하지만 표본이 작아서 생기는 문제까지 해결하지는 못한다.
같은 시드(난수의 시작값)를 줘도 난수 생성기 종류가 다르면 구간이 조금 달라진다. NumPy의 np.random.default_rng(0)과 SciPy의 rng=0(SciPy 1.15 이상 권장)은 같은 생성기를 써서 ≈[4.63, 5.60]으로 일치한다. 예전 방식인 random_state=0은 다른 생성기를 써서 ≈[4.65, 5.60]이 나온다.
Connections
- 순열 검정 — 같은 재표집 계열. 부트스트랩은 복원·추정, 순열은 비복원·가설검정.
- 표준편차 — 부트스트랩이 근사하는 표준오차는 추정량의 표준편차다.
- Pearson 상관계수 — 상관계수의 신뢰구간처럼 공식으로 구하기 까다로운 추정량의 구간을 부트스트랩으로 구할 수 있다.
- Spearman 순위상관계수 — 순위 상관계수의 불확실성도 부트스트랩으로 정량화한다.
- Parametric vs Non-parametric — 분포 가정을 피하는 비모수 추정에 속한다.
- [[몬테카를로 방법]] — 무작위 재표집으로 분포를 근사하는 상위 기법.
Discussion
Comments
댓글은 승인 후 공개됩니다.