2026-07-07 - Lydia Hallie - Claude Code 모델·Effort 레벨 선택
Source
- 저자: Lydia Hallie (Claude Code 팀, member of technical staff)
- 유형: article (Anthropic 공식 블로그)
- 원문: [[Claude Code - effort level and model selection Claude]]
- URL: https://claude.com/blog/claude-model-and-effort-level-in-claude-code
- 수집일: 2026-09-15
- 성격: 벤더 1차 explainer. 모델과 effort의 동작 원리를 그림과 함께 설명한다. 제품 사용을 유도하는 관점이 섞여 있으나 토큰화·추론 메커니즘 서술 자체는 표준적이다.
TL;DR
- Claude Code의 두 설정 model과 effort는 서로 다른 것을 조절한다.
- 모델은 고정된 가중치를 고르는 선택이고, 그 가중치가 출력 토큰당 비용도 정한다.
- effort는 한 요청에서 Claude가 얼마나 많은 일을 하는지, 곧 파일을 몇 개 읽고 얼마나 검증하고 몇 단계까지 밀고 나갈지를 정한다.
- 결과가 틀렸을 때 판단 기준은 하나다. 몰라서 틀렸으면 모델을 올리고 덜 해봐서 틀렸으면 effort를 올린다.
- 대부분의 작업은 기본 effort로 충분하며 속도나 철저함이 특히 중요한 작업에서만 다이얼을 건드린다.
모델이 하는 일
Claude Code에서 엔터를 누르면 메시지·시스템 프롬프트·도구 정의·CLAUDE.md·대화 기록·컨텍스트의 파일이 하나의 API 요청으로 묶여 서버로 간다. 서버가 가장 먼저 하는 일은 토큰화다. 텍스트가 조각으로 쪼개지고 각 조각이 고정된 어휘 사전의 정수로 매핑된다. const가 1978, await가 4293이 되는 식이다. 이 시점부터 프롬프트는 정수 배열이다.
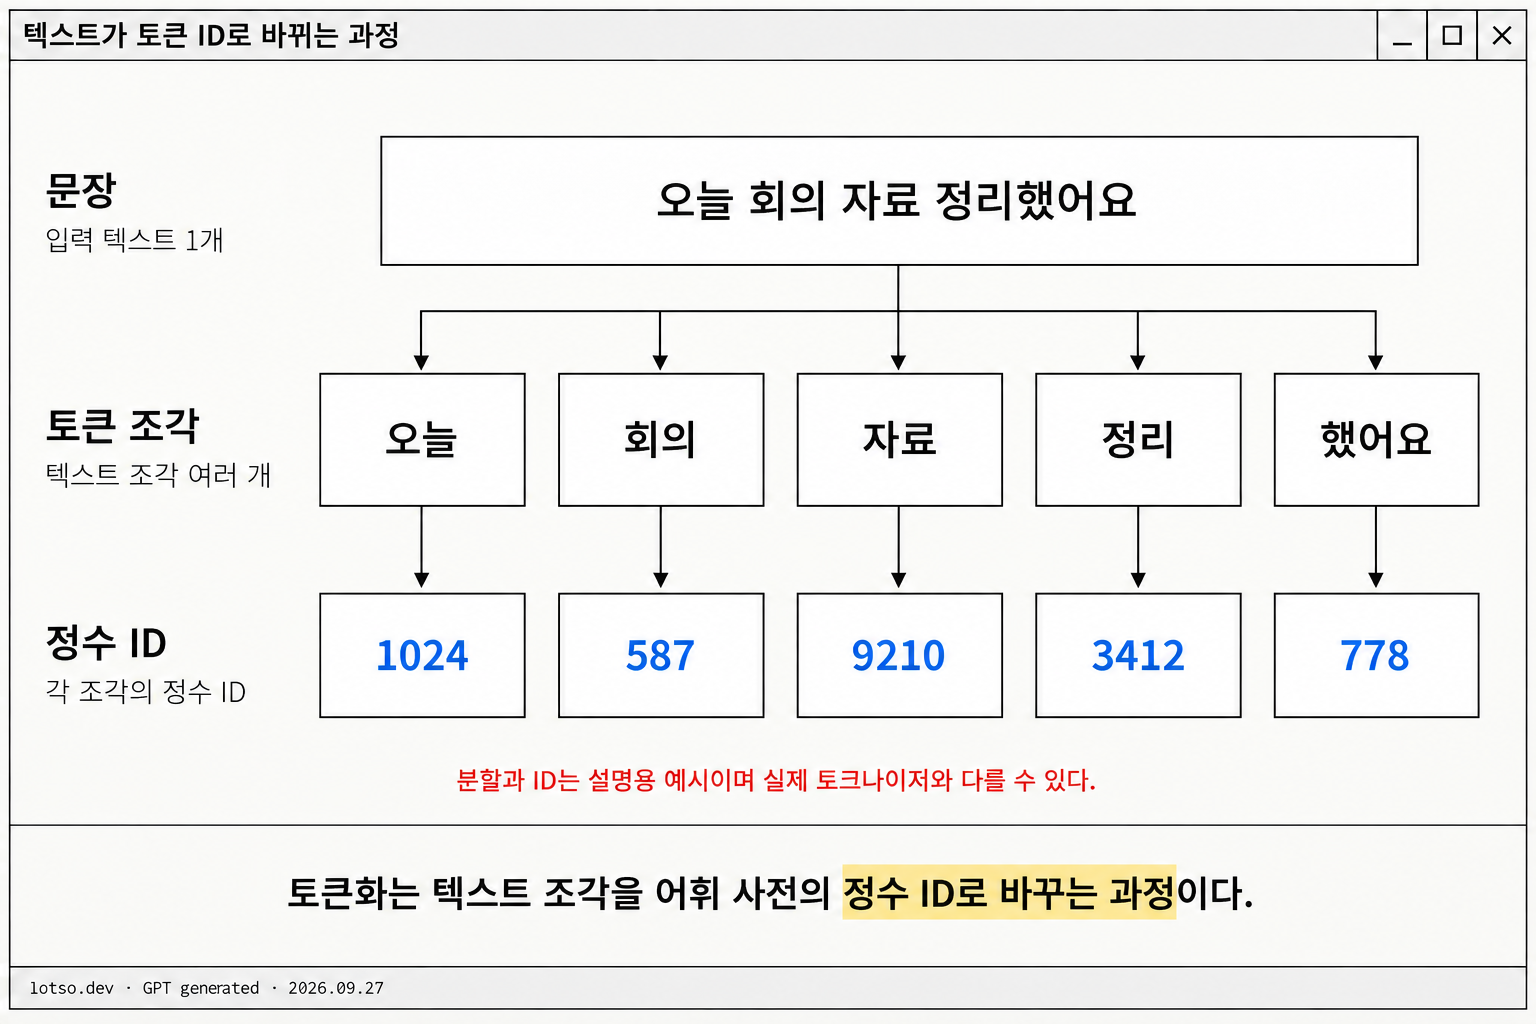
위 그림은 한국어 문장이 토큰 조각으로 쪼개져 각각 정수 ID로 매핑되는 예다. 세부는 [[LLM 토큰과 토큰화]].
원문 그림
"The tokenizer splits your text into pieces and maps each piece to an integer in a fixed vocabulary."
토크나이저가 텍스트를 조각으로 나누고 각 조각을 고정 어휘의 정수 ID로 바꾸는 그림. 상단의 청크가 하단의 토큰 ID가 된다.
모델의 일은 그 배열을 받아 다음에 올 토큰을 예측하는 것이다. 어휘의 모든 토큰에 확률을 매기고 상위에서 고른다. const x = await 다음이라면 잘 학습된 모델은 fetch에 높은 확률을, banana에 0에 가까운 확률을 준다. 입력 토큰을 그 확률로 바꾸는 것이 가중치(weights, parameters)다. 수십억 개의 숫자가 거대한 행렬로 조직돼 있고 토큰 하나를 예측하려면 입력을 그 행렬들에 통과시킨 뒤 끝에서 확률을 읽는다. 모델이 아는 모든 것이 가중치에 들어 있다.
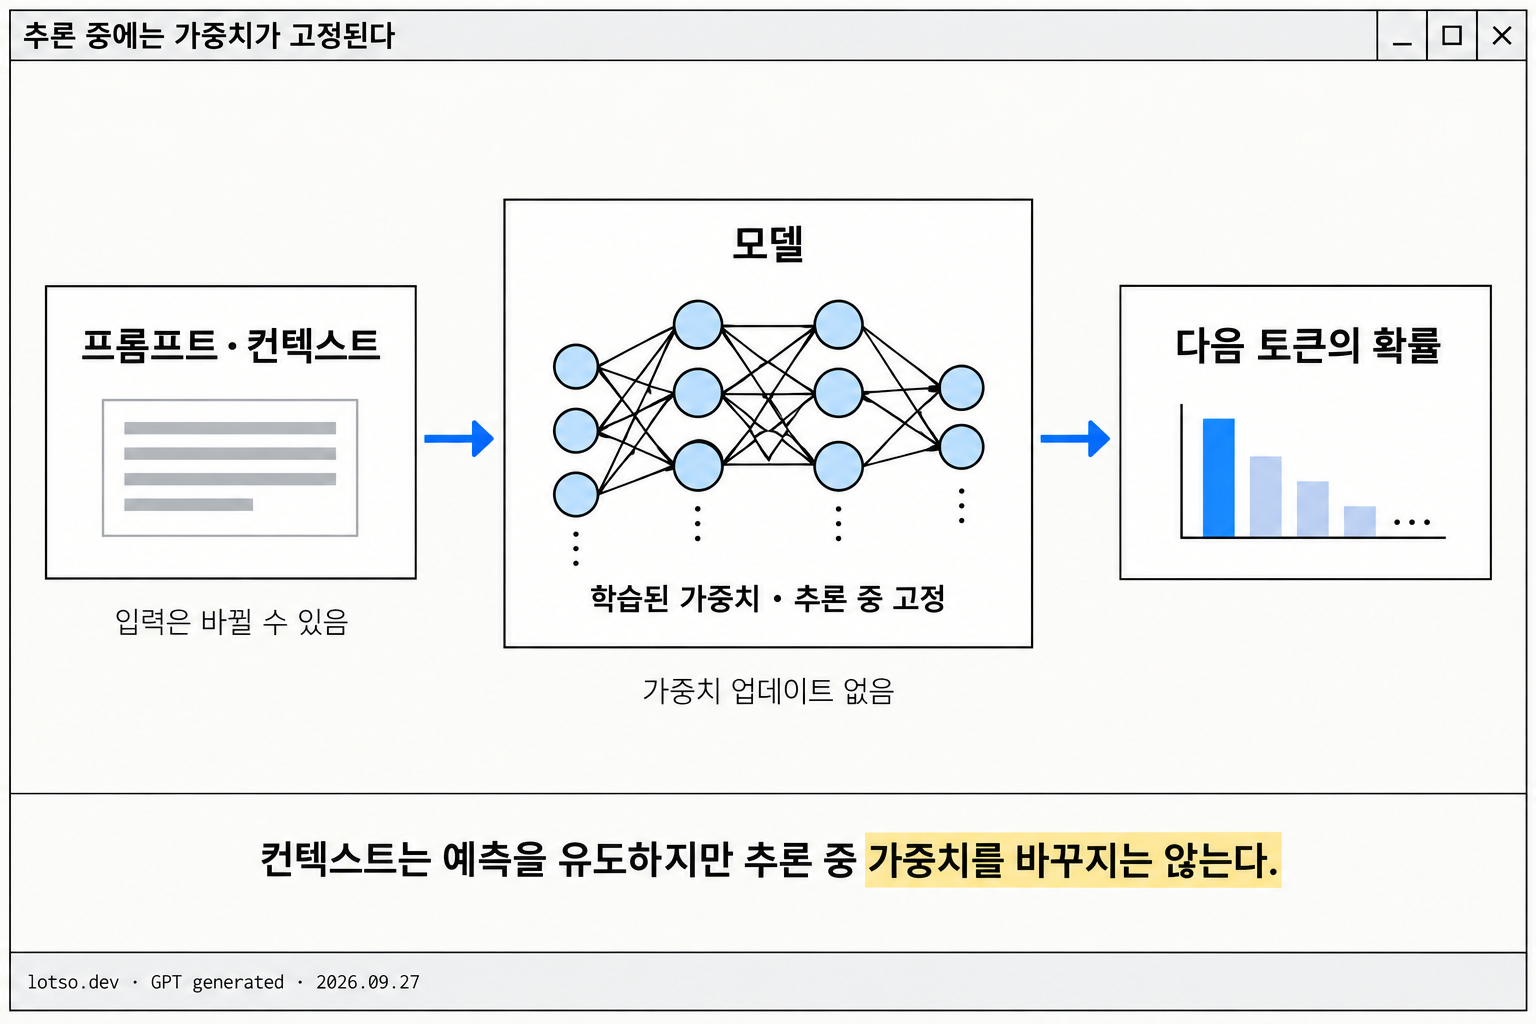
가중치는 학습 때 정해지고 요청을 보내는 시점엔 읽기 전용이다. 프롬프트·CLAUDE.md·컨텍스트 어느 것도 가중치를 바꾸지 않는다. 추론(inference)이라는 말이 바로 이 뜻이다. 학습이 끝난 뒤 가중치를 고정한 채 모델을 쓰는 것.
원문 그림
"Your prompt goes in, probabilities come out. The weights in the middle don't change."
프롬프트와 컨텍스트는 예측을 유도(steer)할 뿐이다. 실제 코드를 Claude 앞에 놓는 것은 강력한 유도이고 잘 통한다. 학습 시점에 없던 라이브러리는 가중치에 없다. 문서를 컨텍스트에 넣으면 Claude가 그걸 쓰지만 가중치에 남기지는 못하고 그 요청 동안만 예측을 유도한다. Claude가 존재하지 않는 API를 자신 있게 호출하는 hallucination도 학습 패턴상 그럴듯해 보이는 토큰열을 만들어낸 결과다. 어딘가를 조회하다 실패한 것이 아니다. 그래서 모델을 바꾼다는 것은 어떤 고정 가중치가 요청을 처리할지를 바꾸는 것이다.
출력이 비싼 이유
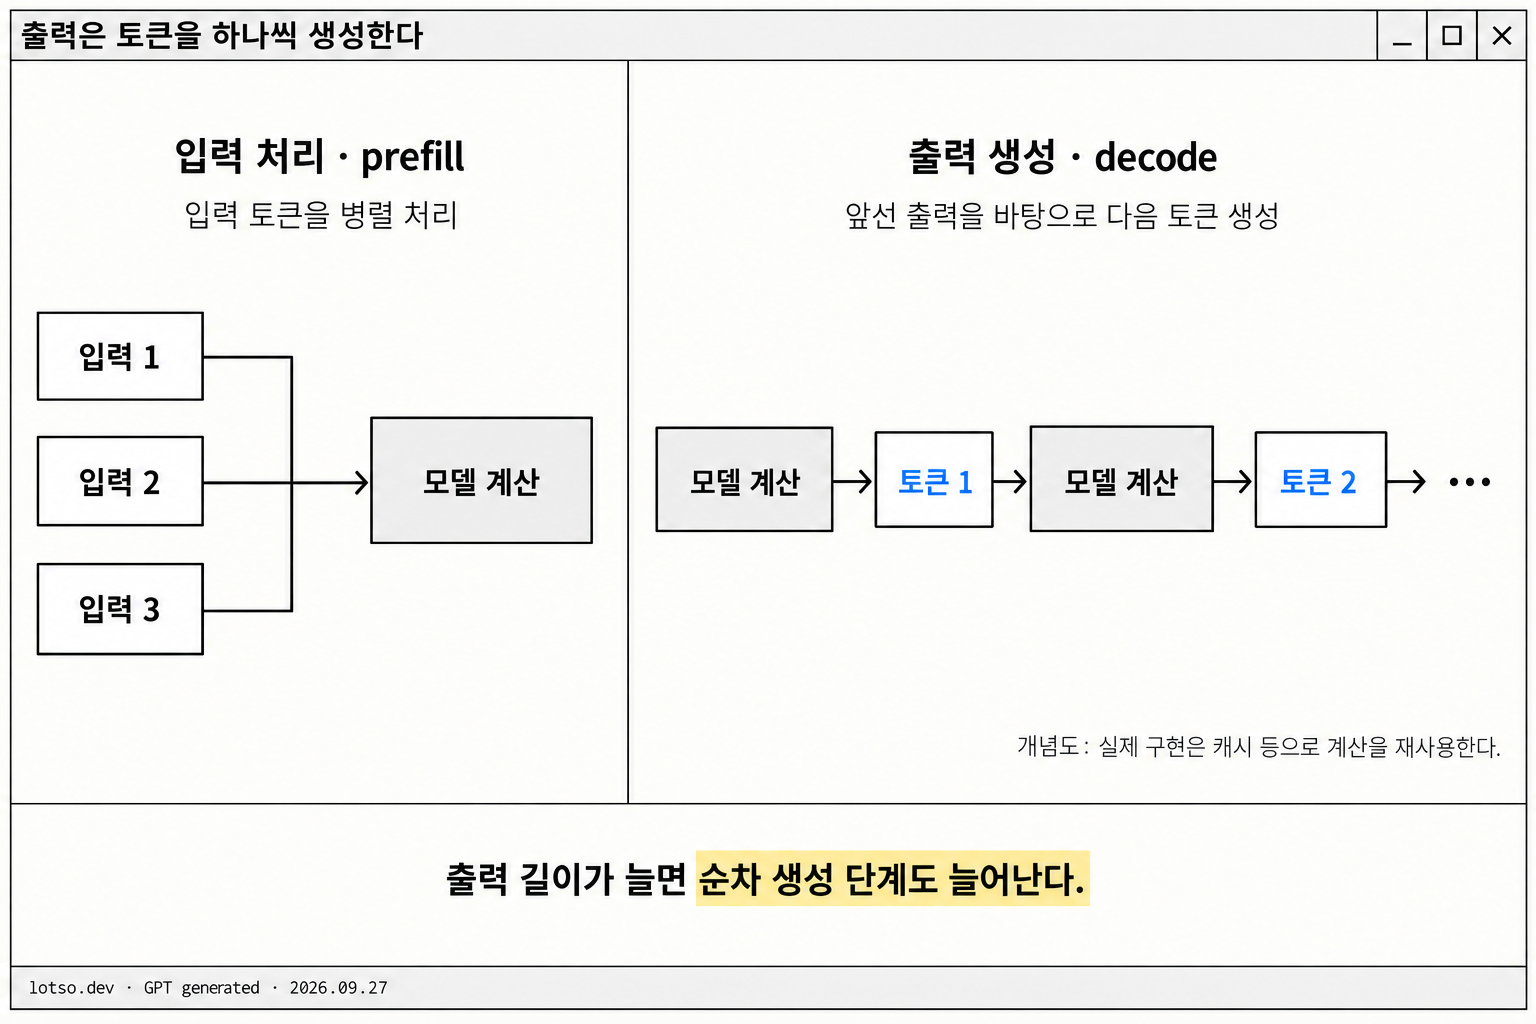
모델은 답을 한 번에 만들지 않는다. 토큰 하나를 예측해 배열에 붙이고 전체 계산을 처음부터 다시 돌려 다음 토큰을 얻는다. 200토큰짜리 응답은 가중치를 200번 통과한 결과다. 대기 시간과 출력 비용의 대부분이 이 루프에서 나온다.
원문 그림
"The sequence grows by exactly one token per step. The model re-reads the whole array each time to predict what comes next."
모델 설정은 어떤 가중치가 요청을 처리할지와 함께 출력 토큰 하나의 비용을 정한다. 몇 개의 토큰이 생성될지는 정하지 않는다. 같은 프롬프트라도 Claude가 얼마나 일하기로 하느냐에 따라 그 수는 크게 달라진다. 그 양을 정하는 것이 effort다.
effort의 정체
작업 중 Claude가 만드는 토큰에는 행동 전후로 흐르는 추론(thinking), Read·Edit 같은 도구를 지정하는 tool call, 계획·진행 보고·마무리 요약처럼 사용자에게 보내는 텍스트가 있다. 셋 다 같은 루프에서 나오는 평범한 출력 토큰이고 같은 요율로 과금된다. thinking 토큰도 다른 출력 토큰과 똑같이 생성되며 그 턴 동안 컨텍스트에 남는다. Claude가 코드를 쓰는 단계로 넘어가면 앞서 한 추론은 읽은 파일과 마찬가지로 입력의 일부가 된다.
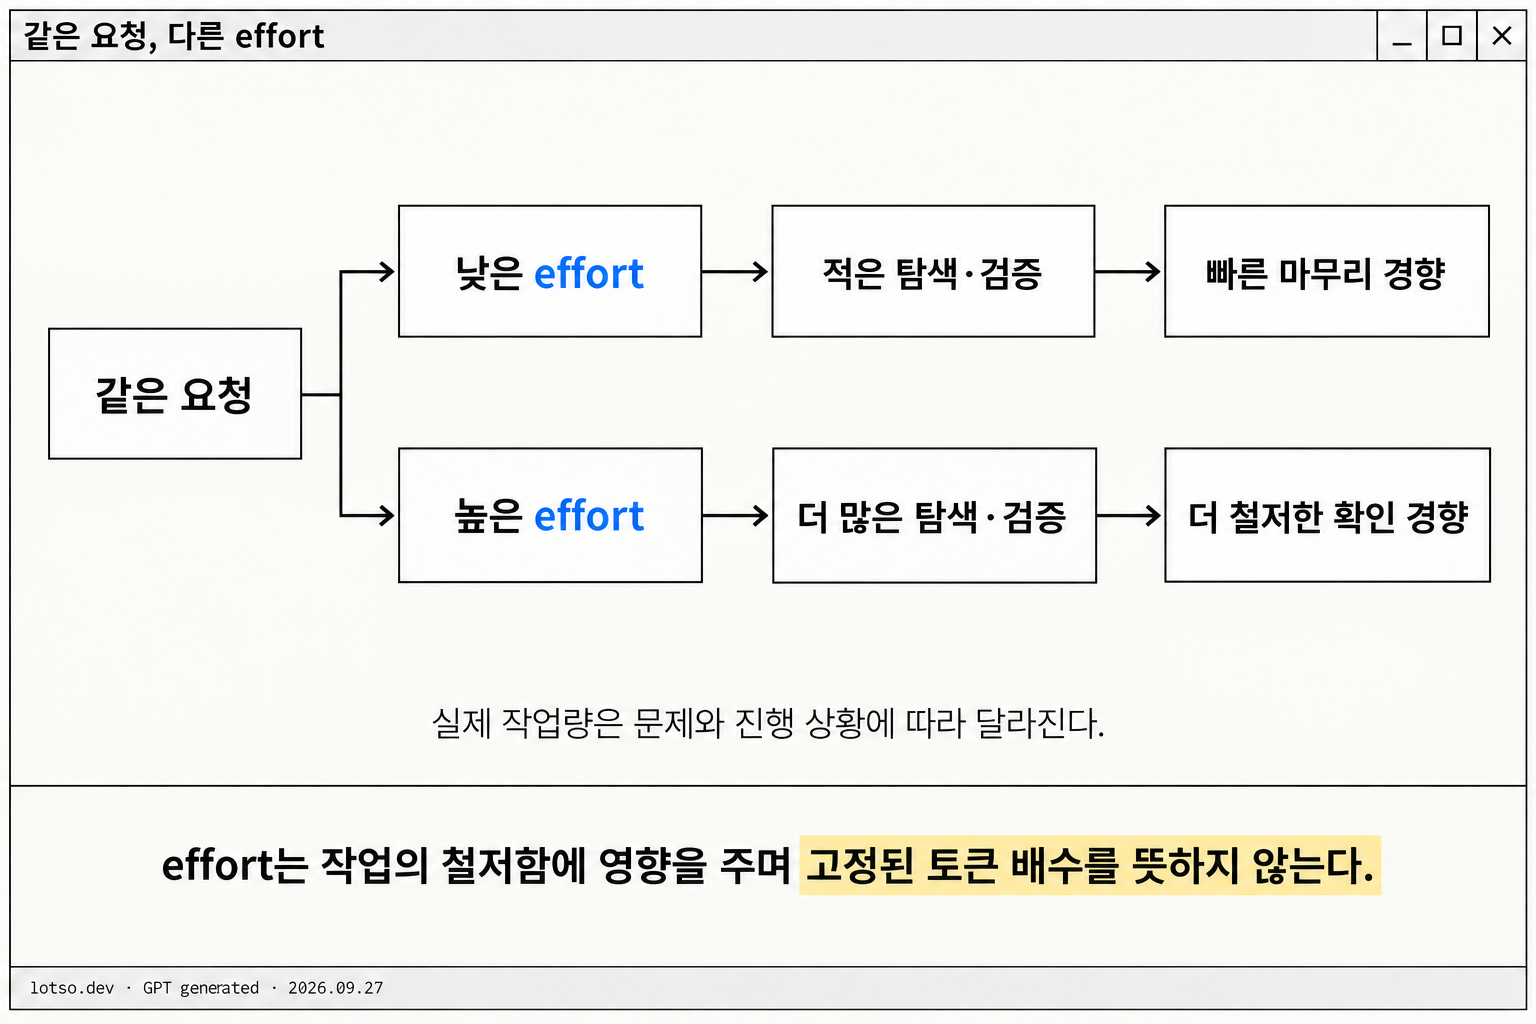
effort 레벨은 프롬프트와 나란히 요청에 실려 모델로 간다. 모델은 각 effort 레벨에서 어떻게 행동할지 학습했고 그 행동이 고정 가중치에 새겨져 있다. 요청이 도착하면 effort는 모델이 반응하는 또 하나의 입력이 되어 작업을 끝났다고 보기까지 얼마나 철저하고 확실해야 하는지를 정한다. 이 판단은 매 턴 이뤄지며 더 높은 확신의 답을 내려고 더 많은 토큰을 쓴다.
원문 그림
"Same prompt, two effort levels. The high effort path generates roughly 7x more tokens to reach a higher confidence answer."
같은 프롬프트를 두 effort로 돌린 그림. 높은 effort 경로가 약 7배 많은 토큰을 써서 더 높은 확신에 도달한다.
높은 effort에서 Claude는 계획부터 세우는 쪽으로 기울고 effort가 그 계획의 깊이와 폭에 영향을 준다. 계획이 고정돼 있지는 않다. 행동 결과를 받으면 진행 상황과 확신 정도를 갱신한다. 세 가설을 세운 디버깅에서 1단계가 버그를 찾으면 2·3단계는 더 이상 필요 없어지고 Claude는 보통 "첫 점검에서 찾았으니 나머지는 불필요하다"고 밝히고 건너뛴다. Claude Code에서 작업 목록이 도중에 수정되는 장면이 이것이다. 높은 effort일수록 추가 가설을 확인하거나 정확성을 재검증하려는 성향이 강해지지만 단순 작업에서 사용량을 인위로 부풀리지는 않는다. 과도한 생각(overthinking)은 효과를 떨어뜨리므로 학습 단계에서 주의 깊게 억제한다.
effort 고르기와 틀렸을 때
기본값은 대부분의 사람이 그 작업에 쓰고 싶어 할 만큼 토큰을 쓰도록 맞춘 설정이다. 원문의 권고는 대부분의 작업에서 모델의 기본 effort를 쓰라는 것이다. effort는 Claude가 얼마나 세게 오래 일할지를 수동으로 덮어쓰는 다이얼로, 철저함이나 속도에 강한 선호가 있을 때만 도메인이나 작업 유형에 맞춰 의도적으로 고른다. 작업마다 매번 정하기보다 일반 성향으로 두는 편이 낫다.
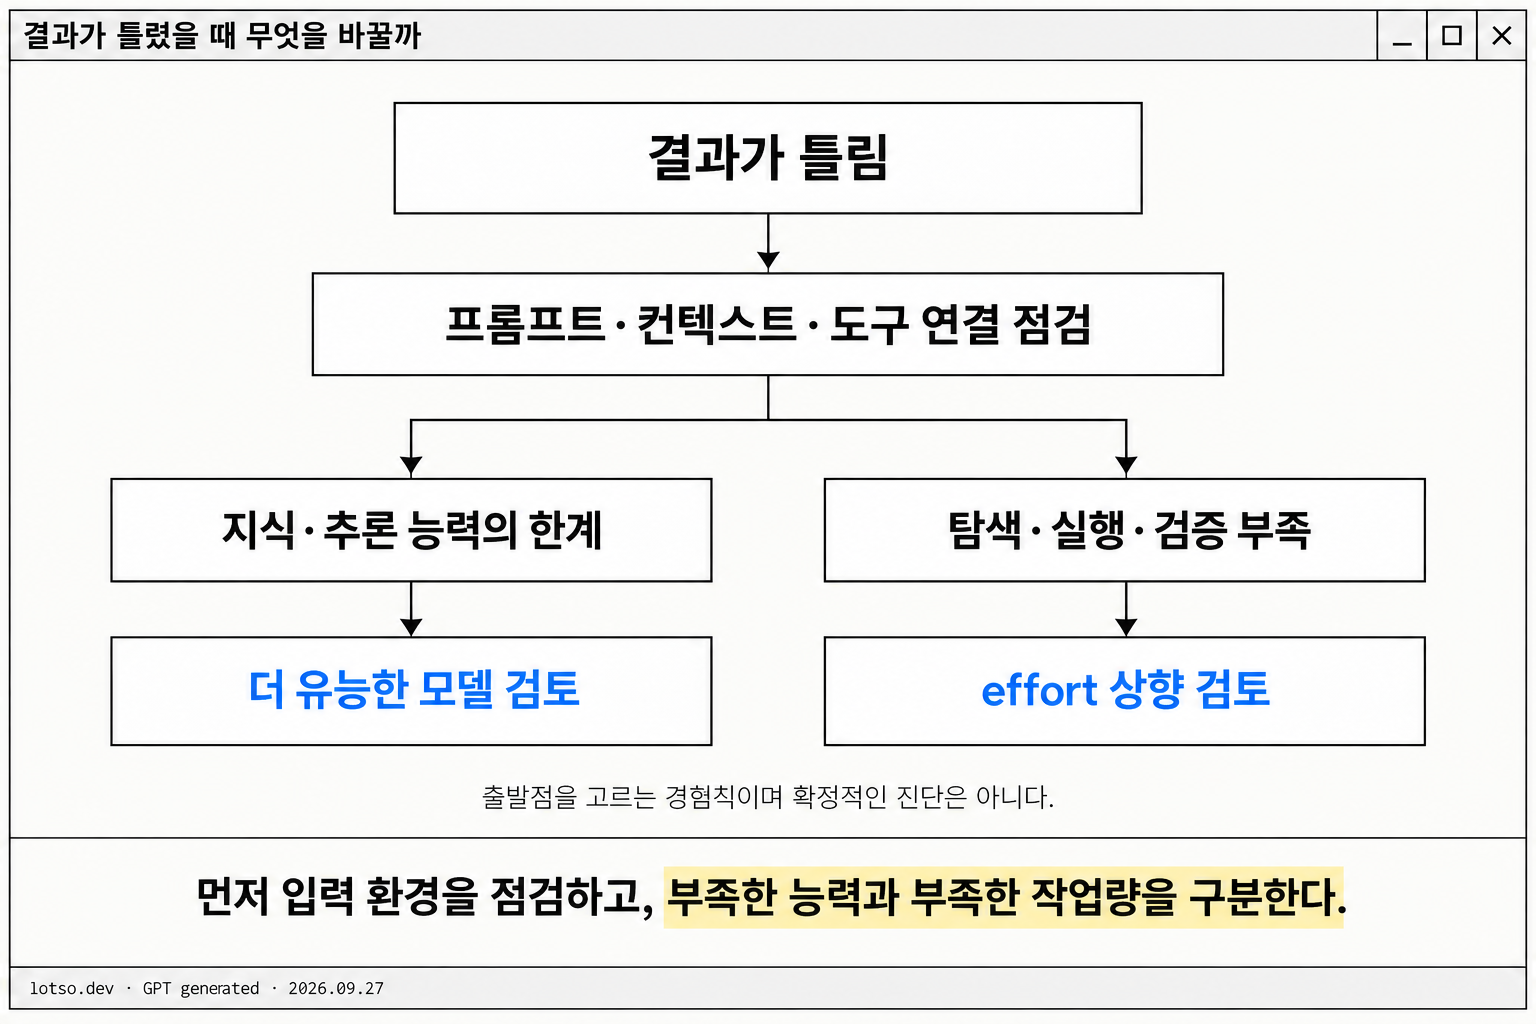
결과가 틀렸다면 다이얼을 돌리기 전에 먼저 준 컨텍스트부터 본다. 프롬프트가 모호했는지, 도구·스킬 연결이 맞는지. 그러고도 틀렸다면 질문은 하나로 좁혀진다.
원문 그림
"Two questions, one fallback. Use the heuristic to pick a starting point, not a hard rule."
몰라서 틀린 경우엔 모델을 올린다. 미묘한 버그, 낯선 도메인, 아키텍처 결정처럼 문제 자체가 어려우면 더 큰 모델을 고른다. 컨텍스트를 아무리 줘도 작은 모델이 계속 자신 있게 틀리는 상황이 그 신호다. 큰 모델은 애매함을 더 잘 다루고 작은 모델에는 실행을 지시하는 구체적 지침이 더 잘 통한다. 반대로 큰 모델에서 한동안 작업이 루틴이었다면 모델을 낮춰 속도를 올리고 품질 손실 없이 비용을 줄인다.
덜 해서 틀린 경우엔 effort를 올린다. 파일 하나만 보고 결론을 냈거나, 테스트를 안 돌렸거나, 리팩터링을 하다 일부만 고쳤다면 여기에 해당한다. 기본값보다 낮은 effort를 골라 둔 상황에서 특히 그렇다.
스페셜리스트·전문가·제너럴리스트
원문 저자의 비유로는 Fable이 거의 아무도 못 본 문제까지 본 스페셜리스트, Opus가 전문가, Sonnet이 아주 좋은 제너럴리스트다. effort는 그중 누구든 작업에 쓰는 시간을 정한다.
낮은 effort의 Opus는 비슷한 문제를 깊이 다뤄본 전문가에게 5분을 얻는 것과 같다. 코드베이스 어디에도 없는 지식, 곧 이전에 본 패턴과 확인할 함정을 가져오지만 5분이라 코드를 꼼꼼히 읽기보다 빠르게 훑는다. 높은 effort의 Sonnet은 아주 좋은 제너럴리스트에게 오후 내내를 주는 것과 같아서 전부 읽고 실행하고 재확인해 그 코드를 철저히 이해하지만 "정확히 이걸 본 적 있다"는 인식은 덜하다. 낮은 effort의 Fable은 모두가 막힌 문제를 흘깃 보고도 아무도 못 짚은 지점을 짚어낸다. 가장 비싸게 값을 치르는 것이 그 인식이라 정말 필요한 작업에 아껴 쓴다. 어느 하나가 늘 낫지는 않다. 모델 설정은 대략 얼마나 유능한가이고 effort 설정은 대략 얼마나 철저한가이며, 실제 작업은 대개 둘 다 필요하다.
비용은 작업에 달렸다
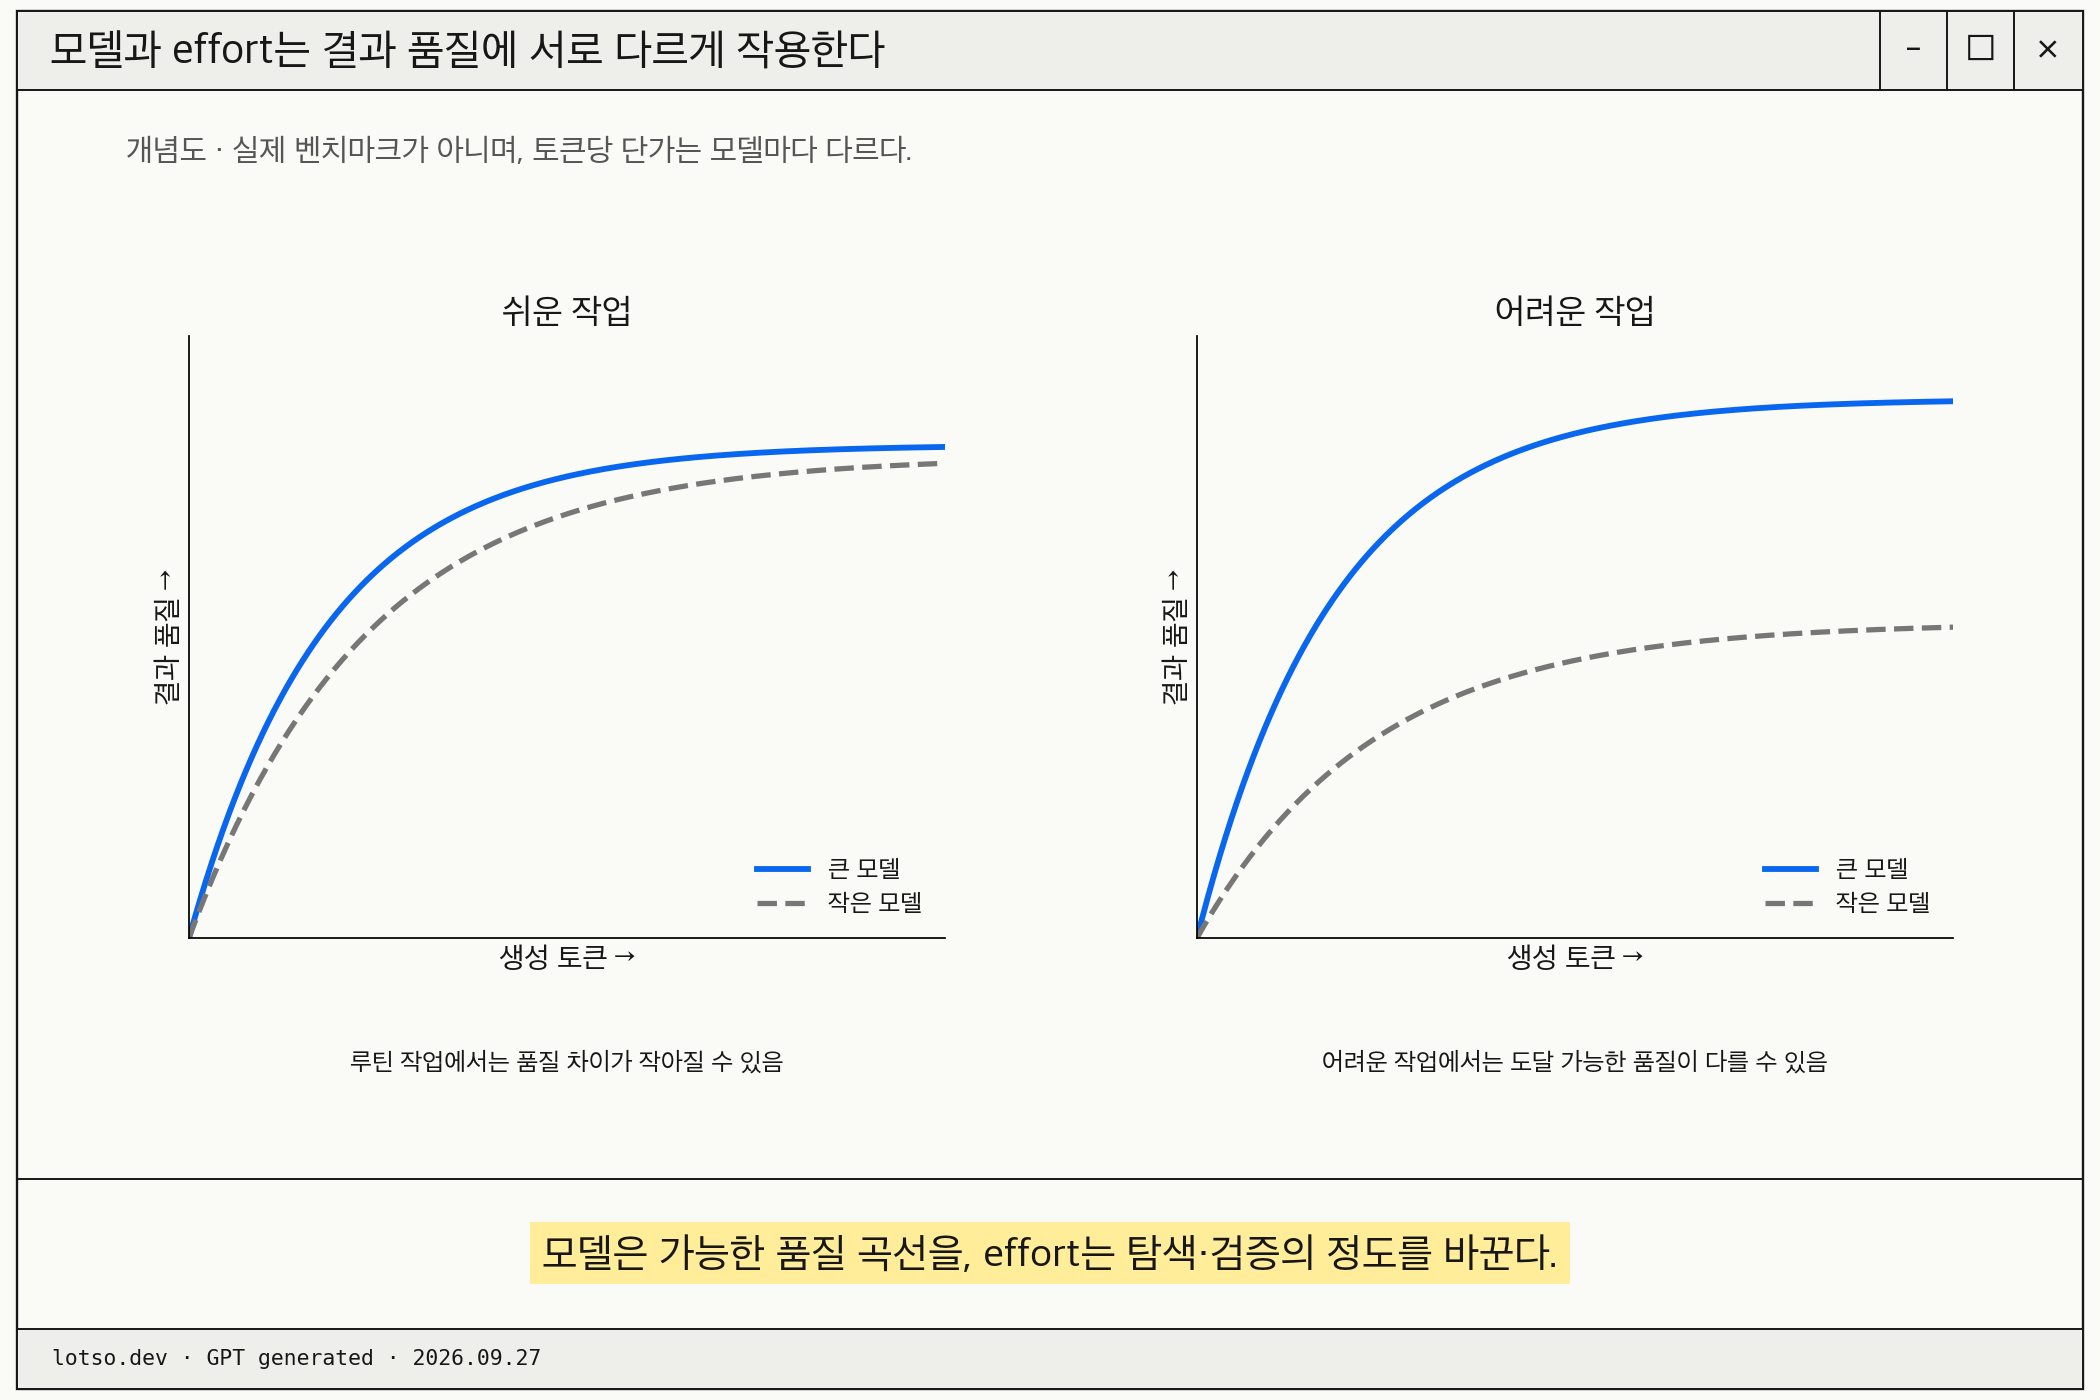
루틴 작업을 같은 effort로 돌리면 두 모델 모두 대개 맞힌다. 큰 모델은 검증 단계가 더 붙어 토큰을 더 쓰고 토큰당 단가도 높다. 그래서 루틴 구간에서 작은 모델로 내리면 품질 손실 없이 실제로 돈을 아낀다. 어렵고 여러 단계인 작업은 계산이 달라진다. 작은 모델은 능력의 한계에 부딪혀 시도를 거듭하고 큰 모델은 더 적은 단계로 같은 품질 기준에 도달한다. 토큰당 단가는 큰 모델이 높지만 작은 모델이 오래 붙잡고 있어야 하는 작업에서는 큰 모델의 태스크당 총비용이 오히려 낮을 수 있다. 무엇보다 큰 모델은 작은 모델이 어떤 effort로도 끝내지 못하는 작업을 해낸다. 이 격차는 Fable에서 가장 크다. 원문 테스트에서 Fable은 Opus·Sonnet이 어떤 effort로도 해내지 못한 작업을 끝냈고 동시에 토큰당 가장 비쌌다.
원문 그림 (2개 곡선 종합)
"On a simple task, the curves converge." · "Model picks the curve. Effort picks how far right Claude is willing to travel."
원문은 쉬운 작업(두 곡선 수렴)과 어려운 작업(큰 모델 곡선이 위)을 각각 품질–토큰 포화 곡선으로 보여준다. 위 그림은 이 둘을 한 장에 종합했다. 곡선은 예시다.
effort는 Claude가 곡선 위를 어디까지 갈지를 정할 뿐 거기까지 반드시 간다는 뜻은 아니다. effort는 토큰 사용량에 영향을 주지만 사용량의 상한을 정하지는 않는다. 시스템의 유일한 hard cap은 max_tokens로, 도달하면 응답을 중간에서 잘라내는 무딘 도구이고 주로 API 개발자에게 해당한다. task budget이나 프롬프트에서 간결히 하라는 요청 같은 부드러운 제어는 모델이 따르도록 학습된 안내다. 부딪히는 벽은 아니어서 한도에 가까워지면 작업을 마무리하려 한다.
Open Questions
- effort 레벨과 실제 토큰 소비의 정확한 배수 관계는 공개돼 있지 않다. "약 7배"는 원문 그림의 예시일 뿐 벤치마크가 아니다.
- 비용 곡선은 예시로 명시돼 있고 실제 벤치 데이터가 아니다. 태스크당 총비용 역전이 어떤 작업 분포에서 성립하는지는 측정이 필요하다.
- effort 이름·단계(low·medium·high·xhigh·max)의 세부 동작은 이 글 밖이며 모델·플랫폼에 종속된다.
Connections
- [[2026-07-08 - 짐코딩 - AI 코딩 도구 모델·Effort 선택 실무]] — 이 글의 한국어 실무 재구성(판단표·프롬프트 템플릿).
- 2026-08-14 - Lydia Hallie - Claude Code 세션 토큰 효율 — 같은 저자의 후속. 토큰 가격과 캐시·세션 운영으로 이어진다.
Discussion
Comments
댓글은 승인 후 공개됩니다.