TL;DR
- 신뢰구간(confidence interval) 은 모수가 있을 만한 범위다.
- 모수는 모집단 전체의 평균처럼 정해져 있지만 우리가 모르는 값이다.
- 표본으로 구한 값 양옆에 오차 범위를 더해 만든다.
- 95%는 표본을 100번 새로 뽑아 구간을 구하면 그중 95개쯤에 모수가 들어 있다는 뜻이다.
- 95%는 계산 방법의 정답률이고 이번에 구한 구간 하나가 맞았는지는 알려 주지 않는다.
- 평균 차이의 95% 신뢰구간에 0이 없으면 두 집단의 평균에 통계적으로 유의한 차이가 있다고 판단한다.
신뢰구간
시험 응시자 전체의 평균 점수를 알고 싶다고 하자. 응시자 전체가 모집단이고 모집단의 평균처럼 하나로 정해져 있지만 보통은 알 수 없는 값을 모수(parameter)라고 한다. 평균이면 모평균이다. 전원을 조사할 수는 없으니 응시자 20명을 뽑아 모평균을 추정한다.
뽑은 20명이 표본이다. 표본 안의 점수 하나하나를 관측값이라고 하고 관측값 개수 을 표본 크기라고 한다. ("표본 개"는 관측값 개를 뜻하기도 하고 표본추출을 번 반복한 결과를 뜻하기도 하므로 문맥을 확인해야 한다.)
20명의 평균 점수처럼 표본으로 구한 숫자를 추정값(estimate)이라고 한다. (추정값을 구하는 계산 방법은 추정량(estimator)이라고 한다.) 다른 20명을 뽑으면 추정값도 달라지는데 표본을 새로 뽑을 때마다 추정값이 달라지는 정도가 [[표준오차]]다.
추정값 하나만 보고는 모평균에서 얼마나 벗어나 있을지 알 수 없으므로 추정값 양옆에 표준오차에 비례하는 폭을 더한 신뢰구간으로 모평균을 추정한다. 신뢰구간은 Neyman(1937)이 제안했다.12
모평균을 아는 가상 실험
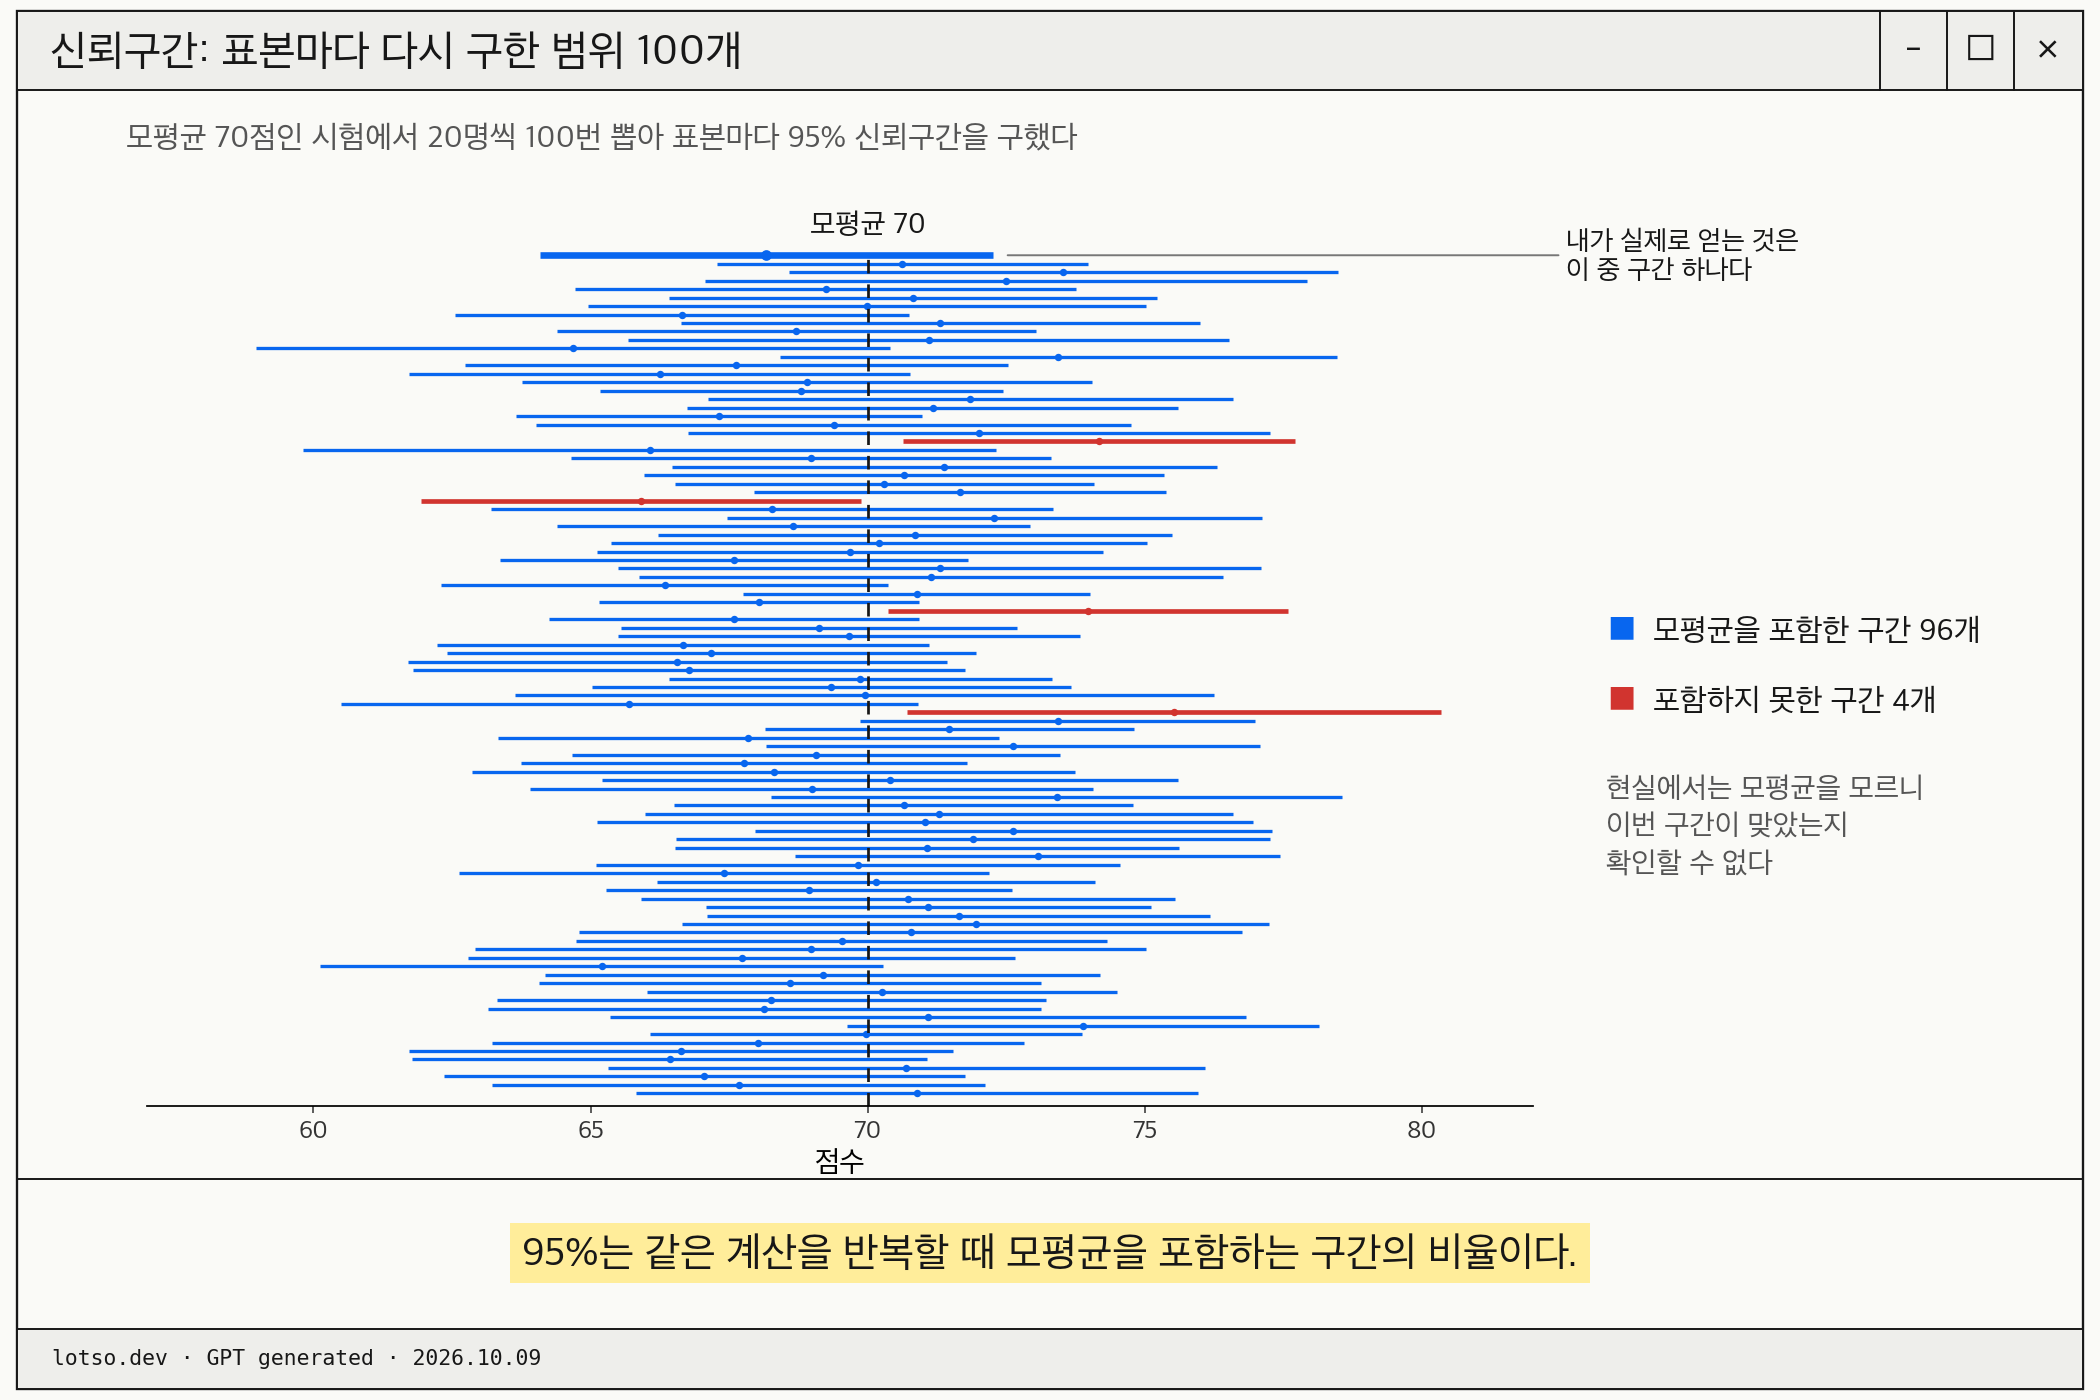
어느 시험의 모평균이 70점이라고 하자. 현실에서는 모르는 값이지만 가상 실험에서는 알고 시작하므로 구간이 맞았는지 확인할 수 있다. 응시자 20명을 뽑아 평균을 내니 68.2점이었고 95% 신뢰구간은 64.1~72.3점이었다. 모평균을 64.1~72.3점 사이로 추정한 것이다.
같은 방식으로 20명씩 100번 새로 뽑아 표본마다 구간을 구한 결과가 위 그림이다. 표본마다 평균도 점수가 흩어진 정도도 달라서 구간의 위치와 폭이 제각각인데 100개 중 96개가 70을 포함했고 4개는 포함하지 못했다.
95%는 같은 계산을 반복할 때 모수를 포함하는 구간의 비율이다. 이번 실험에서는 100개 중 96개였다.
구간이 모수를 포함하는 비율 95%를 신뢰수준(confidence level)이라고 하며 64.1~72.3은 신뢰수준 95%로 구한 신뢰구간이다.
가장 흔한 오해
가장 흔한 오해는 이번에 구한 64.1~72.3점을 보고 "모평균이 이 안에 있을 확률이 95%"라고 읽는 것이다.2 연구자도 자주 틀린다. 연구자 120명과 학생 442명에게 신뢰구간의 틀린 해석 6개를 보여 줬더니 평균 3개 넘게 맞다고 답했다.3
위 실험에서도 100번 중 95번 안팎이 맞았으니 그럴듯하게 들린다. 정답률이 95%인 학생이 정답지 없이 문제 하나를 풀었다고 생각하면 95%가 무엇을 평가한 숫자인지 구분이 쉽다.
| 시점 | 말할 수 있는 것 |
|---|---|
| 문제를 풀기 전 | "이번 문제를 맞힐 확률은 95%" |
| 답을 쓴 뒤 | 답은 이미 맞았거나 틀렸다. 정답지가 없어 채점하지 못할 뿐이다 |
95%는 학생의 실력을 나타내는 숫자다. 이번 답 하나를 채점한 결과는 아니다.
신뢰구간으로 생각해 보면
- 학생은 구간을 구하는 계산 방법,
- 정답률 95%는 신뢰수준,
- 이번 답은 64.1~72.3,
- 정답지는 볼 수 없는 모평균이다.
표본을 뽑기 전이라면 "앞으로 구할 구간이 모평균을 포함할 확률은 95%"라고 말할 수 있지만 64.1~72.3을 구한 뒤에는 모평균이 구간 안에 있거나(100%) 없거나(0%) 둘 중 하나다. 모평균을 모르니 어느 쪽인지 확인하지 못할 뿐이다.2
구간 하나를 두고 "모수가 이 안에 있을 확률"을 말하려면 사전분포(모수가 어떤 값일지에 대한 가정)를 넣고 계산하는 베이즈 신용구간(credible interval)을 써야 한다.2
0을 포함하는지로 판단하기
두 반의 평균 점수를 비교한다고 하자. 두 반에서 학생을 뽑아 구한 표본평균의 차이 로 모평균 차이 를 추정하고 신뢰구간을 구한다. 모평균 차이가 0이면 두 반의 모평균이 같다는 뜻이므로 구간에 0이 들어 있는지 본다. 표본에서는 A반 평균이 B반보다 5점 높게 나왔다고 하자().
- 95% 신뢰구간이 2~8점이면 구간 전체가 0보다 크고 가장 작은 값도 A반이 2점 높은 경우다. 두 반의 모평균에 통계적으로 유의한 차이가 있다고 판단한다.
- 95% 신뢰구간이 −1~11점이면 구간에 0이 들어 있고 B반이 1점 높은 경우까지 포함하므로 어느 반이 높은지 말할 수 없다. 차이가 있다고 판단할 근거가 부족하다.
두 구간 모두 가운데는 5점이고 폭만 다른데 학생을 적게 뽑으면 표준오차가 커져 구간이 0까지 넓어질 수 있다.
0이 들어 있는지로 내린 판단은 같은 방법으로 계산한 [[양측검정]]과 결론이 같다. 0이 95% 구간 밖에 있으면 "차이 = 0"이라는 [[귀무가설]]을 양측 5% [[유의수준]]에서 기각하고 [[p-value]]는 0.05보다 작다.2
식으로 정리
모집단 표준편차 (시그마)를 모를 때 평균의 95% 신뢰구간은 다음과 같다.
가상 실험의 첫 표본(20명, 평균 68.17점, 표준편차 8.73점)으로 하나씩 읽는다.
계산에 사용하는 값 세 개. 표본평균 = 68.17은 뽑은 20명의 평균 점수로 구간의 한가운데에 놓이고 표본 크기 = 20은 뽑은 사람 수다. 표본 표준편차 = 8.73은 학생 한 명의 점수가 평균에서 보통 8.73점쯤 떨어져 있다는 뜻이다.
표준오차 . 표본을 새로 뽑을 때마다 평균이 달라지는 정도인데 표본은 하나뿐이므로 표본 표준편차 를 으로 나눠 추정한다. 이번 표본에서는 다. 한 명의 점수는 8.73점쯤 달라지는데 20명의 평균은 1.95점쯤만 달라진다. 표본 안에서 높은 점수와 낮은 점수가 서로 상쇄되기 때문이다.
1.96. 정규분포에서는 평균 양옆 1시그마(표준편차 1개) 안에 68%, 2시그마 안에 95%가 들어가고 95%를 정확히 맞추는 값은 1.96시그마다([[68-95-99.7 규칙]]). 표본을 여러 번 뽑아 평균을 내면 표본평균들도 모평균을 중심으로 정규분포 모양으로 퍼진다. 점수 분포가 정규분포가 아니어도 표본이 충분히 크면 그렇다는 것이 [[중심극한정리]]다. 표본평균들의 분포에서 1시그마는 모집단 표준편차 를 으로 나눈 표준오차 이므로 표본평균 양옆으로 표준오차의 1.96배를 벌리면 95%의 표본에서 구간이 모평균을 포함한다.
t값 . 1.96은 모집단 표준편차 를 알 때 쓰는 수다. 현실에서는 보통 를 몰라 표본 표준편차 로 대신하는데 도 표본 하나로 구한 추정값이라 와 다를 수 있다(가상 실험의 는 10, 는 8.73). 가 틀릴 수 있는 만큼 [[t분포]](자유도 = 19)에서 구한 조금 더 큰 수 2.093을 곱한다.4 표본이 작으면 1.96으로는 포함 비율이 95%에 못 미치고(정규분포 모집단에서 20명이면 93.5%) 표본이 크면 t값이 1.96과 거의 같아지므로(100명이면 1.984) 평균의 신뢰구간은 보통 t분포로 구한다.
계산.
이번 예시에서 평균의 95% 신뢰구간은 표본평균 양옆으로 표준오차의 약 2배만큼 벌린 범위다.
주의할 점
- 표본이 클수록 폭이 좁다. 폭이 에 비례하므로 폭을 절반으로 줄이려면 표본을 4배로 늘려야 한다.
- 두 구간이 겹쳐도 차이가 유의할 수 있다. 두 집단의 95% 구간이 겹친다는 이유로 차이가 유의하지 않다고 결론 내리지 말고 평균 차이 자체의 신뢰구간이나 검정을 본다.2
- 95%는 가정이 맞을 때의 정답률이다. 표본끼리 독립이 아니거나 모형 가정이 깨지면 구간이 모수를 포함하는 비율이 95%보다 낮아질 수 있다.2
Connections
- [[표준오차]] — 신뢰구간 폭의 기본 단위
- 부트스트랩 — 공식 없이 재표집으로 구간을 구하는 방법과 한 방향 희소 자료의 함정
- [[t분포]] — 모집단 표준편차를 모를 때 구간 폭을 정하는 기준 분포
- [[p-value 해석]] — 같은 판단을 확률 하나로 나타낸 값
- [[단측검정과 양측검정]] — 95% 구간과 대응하는 양측 5% 검정
- [[제1종과 제2종 오류]] — 구간이 모수를 포함하지 못하는 5%는 참인 귀무가설을 기각하는 비율과 대응한다
- [[맥네마 검정]] — 정확도 차이를 신뢰구간과 함께 보고하는 사례
Related MOCs
출처
-
Neyman (1937), Outline of a Theory of Statistical Estimation Based on the Classical Theory of Probability, Philosophical Transactions of the Royal Society A 236 ↩︎
-
Greenland, Senn, Rothman, Carlin, Poole, Goodman & Altman (2016), Statistical tests, P values, confidence intervals, and power: a guide to misinterpretations, European Journal of Epidemiology 31 ↩︎ ↩︎2 ↩︎3 ↩︎4 ↩︎5 ↩︎6 ↩︎7
-
Hoekstra, Morey, Rouder & Wagenmakers (2014), Robust misinterpretation of confidence intervals, Psychonomic Bulletin & Review 21 ↩︎
Discussion
Comments
댓글은 승인 후 공개됩니다.